🔬 الذكاء الاصطناعي تحت المجهر
| المنشور الرابع
لماذا يخمّن الإجابة بدل أن يقول: لا أعرف؟
تسأل نموذج الذكاء الاصطناعي سؤالًا، فيجيبك بثقة تامة.
ثم تكتشف أن إجابته خاطئة...
وربما أن المعلومة التي قدمها لا وجود لها أصلًا.
لماذا لم يقل ببساطة: لا أعرف؟
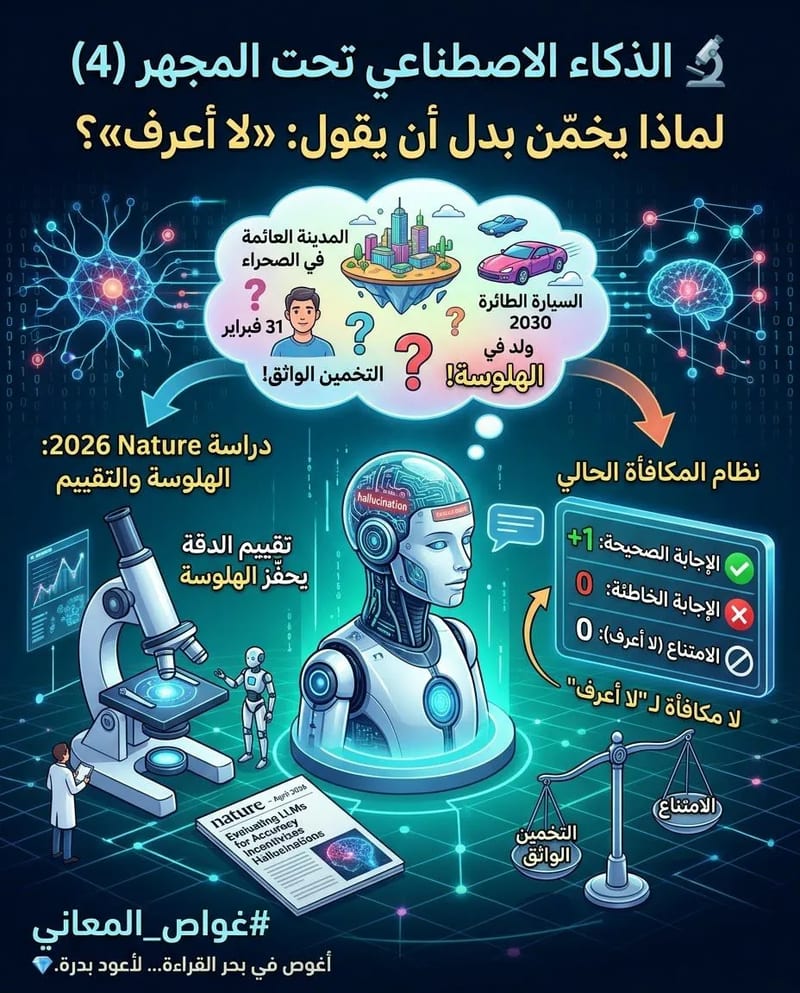
في 22 أبريل 2026، نشرت مجلة Nature دراسة علمية بعنوان تقييم النماذج اللغوية الكبيرة من حيث الدقة يحفّز الهلوسة، شارك فيها باحثون من OpenAI ومعهد جورجيا للتكنولوجيا.
تتناول الدراسة مفارقة مهمة:
قد لا تكون الهلوسة مجرد مشكلة في قدرة النموذج على معرفة الحقائق، بل قد تسهم فيها أيضًا طريقة تدريبه، والمعايير التي نستخدمها للحكم على أدائه.
كيف يحدث ذلك؟
🔹 أولًا: ليس كل ما يمكن صياغته يمكن معرفته
تتدرب النماذج اللغوية على التنبؤ بالرمز النصي التالي، اعتمادًا على الأنماط التي تتعلمها من كميات ضخمة من البيانات.
لكن القدرة على إنتاج عبارة تبدو معقولة لا تعني امتلاك معلومات كافية لإثبات صحتها.
تخيّل أن تسأل نموذجًا عن تاريخ ميلاد شخص غير مشهور، ولا تتوافر عنه معلومات كافية في بيانات التدريب. قد ينتج النموذج تاريخًا يبدو منطقيًا، لكنه لا يملك بالضرورة أساسًا يتيح له تحديد التاريخ الصحيح.
وتوضح الدراسة، من خلال تحليل نظري، أن بعض الأخطاء قد تنشأ حتى عندما تكون بيانات التدريب خالية من الأخطاء؛ لأن البيانات المحدودة لا تتضمن بالضرورة ما يكفي لتعلّم كل حقيقة نادرة أو غير متكررة.
أما الأنماط المتكررة، مثل القواعد اللغوية، فيسهل تعلّمها نسبيًا مقارنة بتفاصيل فردية لا تتوافر لها أنماط تساعد على استنتاجها.
وهنا يجب التمييز بين أمرين: أن يعرف النموذج كيف يصوغ الإجابة، وأن يمتلك معلومات كافية تجعلها صحيحة.
🔹 ثانيًا: ماذا لو لم يحصل الاعتراف بالجهل على أي ميزة؟
تظهر المشكلة أيضًا في طريقة تقييم النماذج.
في كثير من اختبارات الأداء، تُمنح الإجابة الصحيحة درجة، بينما تُعامل الإجابة الخاطئة والامتناع عن الإجابة باعتبارهما فشلًا متساويًا.
تخيّل نموذجًا أمام سؤال لا يعرف إجابته. أمامه خياران: أن يخمّن أو أن يمتنع.
إذا كان التخمين يمنحه فرصة للحصول على درجة، بينما لا يكسب شيئًا من الامتناع، فقد يصبح التخمين الخيار الأفضل وفق معيار التقييم، حتى عندما يكون احتمال الخطأ مرتفعًا.
ولتبسيط الفكرة، لنفترض نظامًا يمنح نقطة للإجابة الصحيحة، ويخصم نقطة للإجابة الخاطئة، ويمنح صفرًا عند الامتناع.
في هذا النظام، إذا كان احتمال صحة الإجابة أقل من 50%، يصبح الامتناع أفضل من التخمين من حيث النتيجة المتوقعة.
لكن إذا كانت الإجابة الصحيحة تمنح نقطة، والخاطئة تمنح صفرًا، والامتناع يمنح صفرًا أيضًا، فلا توجد عقوبة إضافية على التخمين الخاطئ مقارنة بالامتناع.
وهنا قد يشجع معيار الدقة وحده النموذج على المجازفة بالإجابة.
المشكلة إذن ليست أن النموذج يجهل أحيانًا، بل أن بعض طرق تقييمه لا تمنح التحفظ قيمة كافية.
🔹 ثالثًا: هل يمكن تغيير قواعد التقييم؟
تقترح الدراسة ما تسميه التقييم بمعايير معلنة؛ أي توضيح قواعد احتساب الإجابة الصحيحة والخاطئة والامتناع قبل أن يجيب النموذج.
بهذا، لا يُترك النموذج ليستنتج وحده مدى أهمية الخطأ أو ما إذا كان الامتناع مقبولًا، بل تُوضّح له قواعد التقييم التي ينبغي أن يراعيها.
اختبر الباحثون هذه الفكرة على أربعة نماذج متقدمة: Gemini 3 Pro وGPT-5 وGrok 4 وClaude Opus 4.5.
استخدموا أسئلة واقعية من اختبار SimpleQA، ودرسوا أسلوبًا لتقليل الهلوسة يعتمد على توليد إجابتين مستقلتين، ثم مقارنة مدى اتساقهما؛ فإذا ظهر تعارض، يمتنع النموذج عن تقديم الإجابة بدلًا من اختيار إحداهما مباشرة.
أظهرت التجربة أن إعلان معايير التقييم جعل هذا الأسلوب أكثر جدوى وفق نظام الدرجات المستخدم، مقارنة بالتقييم الذي لا يوضح للنموذج كيفية احتساب الامتناع والخطأ.
لكن من المهم فهم حدود النتيجة:
لم تختبر الدراسة جميع النماذج أو جميع وسائل تقليل الهلوسة، كما أن اتفاق إجابتين لا يثبت صحتهما؛ فقد تتفق إجابتان على المعلومة الخاطئة نفسها.
إذن، نحن أمام طريقة لتحسين الحوافز التي تؤثر في سلوك النموذج، لا أمام حل نهائي يضمن صحة الإجابات.
🔹 رابعًا: ماذا تعني هذه النتائج لنا؟
تعني أن تقييم الذكاء الاصطناعي لا ينبغي أن يقتصر على سؤال واحد:
كم إجابة صحيحة استطاع تقديمها؟
بل ينبغي أن نسأل أيضًا:
هل يعرف متى تكون المعلومات المتاحة غير كافية؟
هل يميّز بين الحقيقة التي يستطيع دعمها والتخمين الذي لا يستند إلى دليل؟
هل يمتنع عندما تكون مخاطر الخطأ أكبر من فائدة الإجابة؟
وهل تُكافئه طريقة التقييم على هذا السلوك أم تعاقبه عليه؟
وتزداد أهمية هذه الأسئلة عندما نتعامل مع معلومات طبية أو قانونية أو مالية أو غيرها من المجالات التي قد تترتب على الخطأ فيها عواقب حقيقية.
ومع ذلك، لا يكفي أن يقول النموذج لا أعرف حتى نعدّه موثوقًا؛ فالموثوقية تتطلب أيضًا البحث عن المعلومات عند الحاجة، وتوضيح حدود المعرفة، والتمييز بين ما تم التحقق منه وما لا يزال غير مؤكد.
📌 الخلاصة:
النموذج الأكثر موثوقية ليس الذي يجيب عن كل سؤال، ولا الذي يمتنع عن الإجابة كلما واجه صعوبة، بل الذي يوازن بين تقديم المساعدة واحترام حدود المعلومات المتاحة.
وتقع مسؤولية ذلك على أكثر من طرف: من يصمم النموذج ويدرّبه، ومن يضع معايير تقييمه، ومن يستخدم إجاباته دون أن يخلط بين الثقة والدقة.
فالثقة في الإجابة لا تجعلها حقيقة، والاعتراف بعدم اليقين ليس ضعفًا في حد ذاته؛ بل قد يكون الخطوة التي تمنع خطأً كان يمكن تجنبه.
والآن... لو كان بإمكانك الاختيار، فأيهما تفضّل:
• نموذجًا يجيب عن معظم أسئلتك مع احتمال أن يخمّن بثقة... أم نموذجًا يوضح حدود معرفته ويمتنع حين لا يملك أساسًا كافيًا للإجابة؟ ولماذا؟
📚 المصدر العلمي:
Kalai, A. T. et al. Evaluating large language models for accuracy incentivizes hallucinations. Nature، المجلد 653، الصفحات 1047–1051، 2026. نُشرت الدراسة إلكترونيًا في 22 أبريل 2026.
#الذكاء_الاصطناعي #البحث_العلمي #التقنية #غواص_المعاني
أغوص في بحر القراءة... لأعود بدرة.💎
33