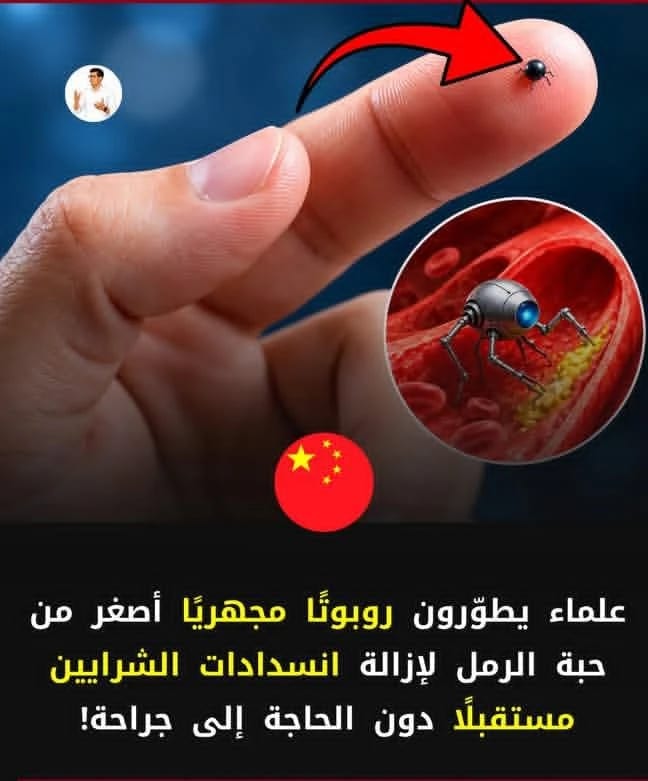
🤖😱 روبوت أصغر من حبة الرمل قد ينقذ مرضى انسداد الشرايين مستقبلًا!
🔬 طوّر باحثون بجامعة دريكسل الأمريكية روبوتات مجهرية تتحرك داخل السوائل باستخدام المجالات المغناطيسية.
🩸 الهدف؟ المساعدة في إزالة ترسّبات الكوليسترول من الشرايين وإيصال الأدوية بدقة إلى المناطق المصابة!
⚠️ التقنية لا تزال تجريبية، ولم تصبح علاجًا معتمدًا للبشر بعد.
🤯 هل تتخيل روبوتات متناهية الصغر تعمل داخل جسم الإنسان؟
#الذكاء_الاصطناعي#الروبوتات#الطب#اكتشافات_علمية#التكنولوجيا
السلام عليكم جميعاً 👋
أنا ناصر العماري مطور برمجيات ومهتم بالذكاء الاصطناعي والتقنية بشكل عام.
من فترة تعرفت على تطبيق مجتمع ولما دخلت أتصفح لاحظت أن المحتوى البرمجي قليل نوعاً ما فقلت ليش ما أبدأ أشارك هنا بعض الأشياء اللي أتعلمها وأجربها.
إن شاء الله بحاول أشارك معكم معلومات تقنية وتجارب في البرمجة والذكاء الاصطناعي وأحياناً أشياء من المشاريع اللي أشتغل عليها.
والهدف مش بس أني أشارك معلومات بالعكس حاب أتعرف على أشخاص عندهم نفس الاهتمامات ونتبادل الخبرات ونتعلم من بعض.
وبما أني جديد هنا خلوني أسألكم:
مين هنا مهتم بالبرمجة أو الذكاء الاصطناعي؟ وأيش أكثر مجال تقني يشد اهتمامكم؟ 👀
#برمجة#تقنية#الذكاء_الاصطناعي
يعتقد كثير من الكتاب والمثفقين والعاملين في حقل الصحافة والأعلام، أن الاصطناعي، سيأخذ وظيفتهم تماماً، وأنهم أول المستهدفين من قبل وحش الـai، والآن كثير منهم يندب حظه النحس! فهل فعلاً سيجردهم الـai من وظيفتهم؟ نظرياً: نعم. ولكن في حقيقة الأمر لن يفعل ذلك بالشكل الذي يتم تصويره الآن.
يقول رئيس شركة إنفيديا:" الذكاء الاصطناعي لن يأخذ وظيفتك. ولكنك ستخسرها في حال لم تتقن استخدامه كمساعد في وظيفتك"
ما هدف الكتابة، أي كتابة؟
- إيصال معنى معين للجمهور. فالمهم أن يصل هذا المعنى للجمهور بعض النظر عن الوسيلة التي كتب بها.
أن يستمر التدفق المعرفي، أن يستمر نشر الوعي وتعزيز المعرفة والثقافة. إذن الذكاء الاصطناعي سيساهم في نشر المعرفة، وهو الهدف الذي يسعى خلفه كل كاتب.
إذن على دور النشر والمواقع الصحفية والأخبار، أن تكف عن رفض النصوص المكتوبة بالذكاء الاصطناعي. إذا كان النص مكتوب بأسلوب جيد ويقدم فكرة جيدة.
حقيقة لابد منها:
الذكاء الاصطناعي، لا يعطيك طلبك كما تريده حرفياً، حتى وإن كتبت له البرومنت/ الأمر، بشكل مفصل، أيضًا حتى وإن قلت له: اكتبه بأسلوبي( بحكم أنه قد بات يعرف فكرك وأسلوبك). وهنا لا بد من تدخلك الذي يصل أحياناً لإعادة صياغة النص كاملاً ليقول ما تريد إيصاله.
فإذا قام كاتب، بطرح فكرة معينة، بشكل معين، وقراءة معينة على الذكاء الاصطناعي، وقام الأخير بكتابتها. وكتبها كما تريده نفسه. فإن هذا النص يعتبر نصاً أصيلاً بأصالة فكرته التي لم يخرجها غيره بهذا الشكل. وهذا يعيدنا، إلى أن الهدف من الكتابة: استمرار تقديم الوعي والمعرفة.
شيء آخر: الذكاء الاصطناعي لن يأخذ الوظائف بقدر ما سيكون مساعد لأصحاب الوظائف في إنتاج أعمال بسهولة ويسر وسرعة. فلن يخرج بنصوص جيدة تحمل أفكاراً عميقة وتطرحها بأسلوب عميق، سوى الكاتب. والفرق بين نص أخرجه كاتب من الذكاء الاصطناعي وبين نص أخرجه إنسان عادي، سيظل فرقاً جوهرياً وواضحاً، لخبراء الكتابة والتحرير. وهذا ما يعزز فكرة أن الذكاء الاصطناعي سيساهم بشكل جيد في تحسين وثراء الكتابة والنشر. بالاستخدام الجيد والمدروس.
حتى أن الإنسان العادي، أي غير الكاتب، ستكون مسألة كتابة نصوص جيدة وعميقة من الذكاء الاصطناعي، مضنية، ولن يتكيف معاها، سوى الكاتب حقيقي ممارس لمهنة الكتابة.
وهكذا بالنسبة لمهن أخرى، كالتصميم مثلاً، فالإنسان العادي، أي غير المصمم، حين يصمم عملاً بالـai لن يكون بإحترافية وجمال المصمم الحقيقي. فالخيال والخبرة يلعبان الدور الرئيسي، بالتالي، لن تطرد المنشأة المصمم وتستبدله بالـai، لأنها ستحتاج لخبير يستخدم الذكاء الاصطناعي في التصميم.
هذا المقال، اكتبه أنا الآن، لأنني لو طلبته من الـai لن يكتبه كما أردت حرفياً، مع ذلك سأحتاجه في أمور أخرى، كأن استعين به في مراجعته لغوياً. بذلك الفعل، سأوفر عناء المراجع اللغوي في الموقع، والذي ربما يتم إعفاءه من هذه الوظيفة(مثل هذه الوظائف سيبتلعها الذكاء الاصطناعي)، حتى أنني سأوفر على هيئة التحرير وقت مراجعته في أداءة مراجعة تعمل بالـai، وسيكون جاهز للنشر.
ختاماً، لنخفف الرهبة التي صنعها الـai في نفوس كثير من الناس، ولنتعامل معه كحقيقة وأمر واقع، وذلك بالاستغلال الأمثل له، في توسيع دائرة الوعي وتحقيق أقصى نهوض وتقدم.
الكتابة والذكاء الاصطناعي
حسام الحاتمي
#الذكاء_الاصطناعي
| المنشور الرابع
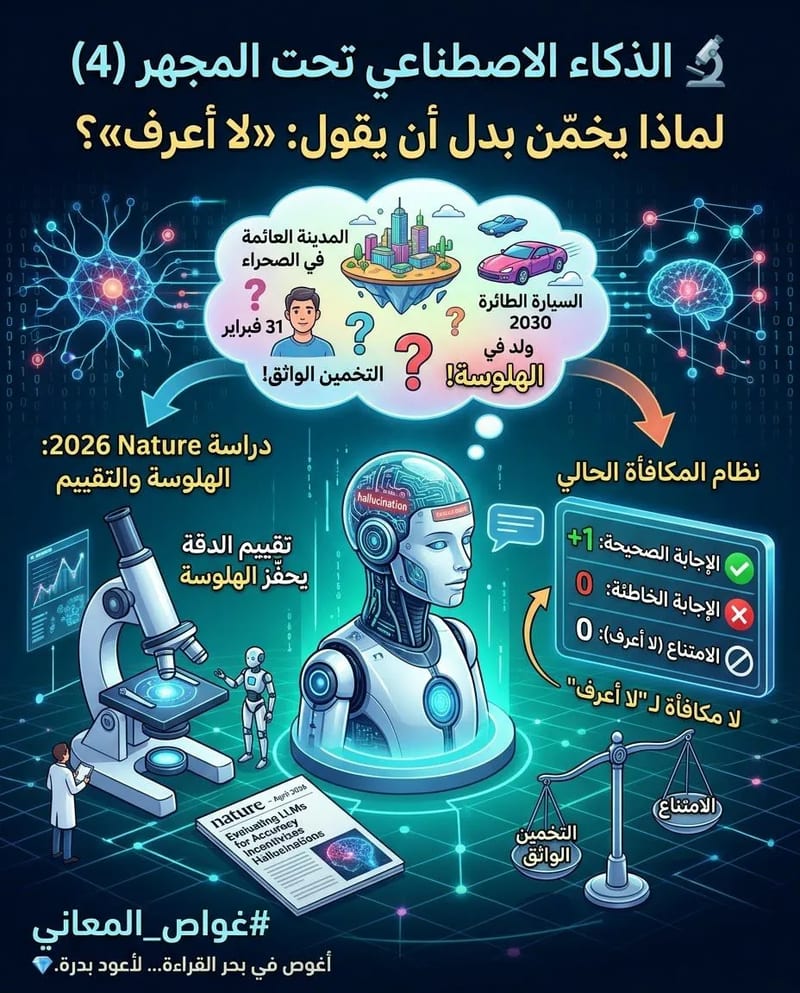
لماذا يخمّن الإجابة بدل أن يقول: لا أعرف؟
تسأل نموذج الذكاء الاصطناعي سؤالًا، فيجيبك بثقة تامة.
ثم تكتشف أن إجابته خاطئة...
وربما أن المعلومة التي قدمها لا وجود لها أصلًا.
لماذا لم يقل ببساطة: لا أعرف؟
في 22 أبريل 2026، نشرت مجلة Nature دراسة علمية بعنوان تقييم النماذج اللغوية الكبيرة من حيث الدقة يحفّز الهلوسة، شارك فيها باحثون من OpenAI ومعهد جورجيا للتكنولوجيا.
تتناول الدراسة مفارقة مهمة:
قد لا تكون الهلوسة مجرد مشكلة في قدرة النموذج على معرفة الحقائق، بل قد تسهم فيها أيضًا طريقة تدريبه، والمعايير التي نستخدمها للحكم على أدائه.
كيف يحدث ذلك؟
🔹 أولًا: ليس كل ما يمكن صياغته يمكن معرفته
تتدرب النماذج اللغوية على التنبؤ بالرمز النصي التالي، اعتمادًا على الأنماط التي تتعلمها من كميات ضخمة من البيانات.
لكن القدرة على إنتاج عبارة تبدو معقولة لا تعني امتلاك معلومات كافية لإثبات صحتها.
تخيّل أن تسأل نموذجًا عن تاريخ ميلاد شخص غير مشهور، ولا تتوافر عنه معلومات كافية في بيانات التدريب. قد ينتج النموذج تاريخًا يبدو منطقيًا، لكنه لا يملك بالضرورة أساسًا يتيح له تحديد التاريخ الصحيح.
وتوضح الدراسة، من خلال تحليل نظري، أن بعض الأخطاء قد تنشأ حتى عندما تكون بيانات التدريب خالية من الأخطاء؛ لأن البيانات المحدودة لا تتضمن بالضرورة ما يكفي لتعلّم كل حقيقة نادرة أو غير متكررة.
أما الأنماط المتكررة، مثل القواعد اللغوية، فيسهل تعلّمها نسبيًا مقارنة بتفاصيل فردية لا تتوافر لها أنماط تساعد على استنتاجها.
وهنا يجب التمييز بين أمرين: أن يعرف النموذج كيف يصوغ الإجابة، وأن يمتلك معلومات كافية تجعلها صحيحة.
🔹 ثانيًا: ماذا لو لم يحصل الاعتراف بالجهل على أي ميزة؟
تظهر المشكلة أيضًا في طريقة تقييم النماذج.
في كثير من اختبارات الأداء، تُمنح الإجابة الصحيحة درجة، بينما تُعامل الإجابة الخاطئة والامتناع عن الإجابة باعتبارهما فشلًا متساويًا.
تخيّل نموذجًا أمام سؤال لا يعرف إجابته. أمامه خياران: أن يخمّن أو أن يمتنع.
إذا كان التخمين يمنحه فرصة للحصول على درجة، بينما لا يكسب شيئًا من الامتناع، فقد يصبح التخمين الخيار الأفضل وفق معيار التقييم، حتى عندما يكون احتمال الخطأ مرتفعًا.
ولتبسيط الفكرة، لنفترض نظامًا يمنح نقطة للإجابة الصحيحة، ويخصم نقطة للإجابة الخاطئة، ويمنح صفرًا عند الامتناع.
في هذا النظام، إذا كان احتمال صحة الإجابة أقل من 50%، يصبح الامتناع أفضل من التخمين من حيث النتيجة المتوقعة.
لكن إذا كانت الإجابة الصحيحة تمنح نقطة، والخاطئة تمنح صفرًا، والامتناع يمنح صفرًا أيضًا، فلا توجد عقوبة إضافية على التخمين الخاطئ مقارنة بالامتناع.
وهنا قد يشجع معيار الدقة وحده النموذج على المجازفة بالإجابة.
المشكلة إذن ليست أن النموذج يجهل أحيانًا، بل أن بعض طرق تقييمه لا تمنح التحفظ قيمة كافية.
🔹 ثالثًا: هل يمكن تغيير قواعد التقييم؟
تقترح الدراسة ما تسميه التقييم بمعايير معلنة؛ أي توضيح قواعد احتساب الإجابة الصحيحة والخاطئة والامتناع قبل أن يجيب النموذج.
بهذا، لا يُترك النموذج ليستنتج وحده مدى أهمية الخطأ أو ما إذا كان الامتناع مقبولًا، بل تُوضّح له قواعد التقييم التي ينبغي أن يراعيها.
اختبر الباحثون هذه الفكرة على أربعة نماذج متقدمة: Gemini 3 Pro وGPT-5 وGrok 4 وClaude Opus 4.5.
استخدموا أسئلة واقعية من اختبار SimpleQA، ودرسوا أسلوبًا لتقليل الهلوسة يعتمد على توليد إجابتين مستقلتين، ثم مقارنة مدى اتساقهما؛ فإذا ظهر تعارض، يمتنع النموذج عن تقديم الإجابة بدلًا من اختيار إحداهما مباشرة.
أظهرت التجربة أن إعلان معايير التقييم جعل هذا الأسلوب أكثر جدوى وفق نظام الدرجات المستخدم، مقارنة بالتقييم الذي لا يوضح للنموذج كيفية احتساب الامتناع والخطأ.
لكن من المهم فهم حدود النتيجة:
لم تختبر الدراسة جميع النماذج أو جميع وسائل تقليل الهلوسة، كما أن اتفاق إجابتين لا يثبت صحتهما؛ فقد تتفق إجابتان على المعلومة الخاطئة نفسها.
إذن، نحن أمام طريقة لتحسين الحوافز التي تؤثر في سلوك النموذج، لا أمام حل نهائي يضمن صحة الإجابات.
🔹 رابعًا: ماذا تعني هذه النتائج لنا؟
تعني أن تقييم الذكاء الاصطناعي لا ينبغي أن يقتصر على سؤال واحد:
كم إجابة صحيحة استطاع تقديمها؟
بل ينبغي أن نسأل أيضًا:
هل يعرف متى تكون المعلومات المتاحة غير كافية؟
هل يميّز بين الحقيقة التي يستطيع دعمها والتخمين الذي لا يستند إلى دليل؟
هل يمتنع عندما تكون مخاطر الخطأ أكبر من فائدة الإجابة؟
وهل تُكافئه طريقة التقييم على هذا السلوك أم تعاقبه عليه؟
وتزداد أهمية هذه الأسئلة عندما نتعامل مع معلومات طبية أو قانونية أو مالية أو غيرها من المجالات التي قد تترتب على الخطأ فيها عواقب حقيقية.
ومع ذلك، لا يكفي أن يقول النموذج لا أعرف حتى نعدّه موثوقًا؛ فالموثوقية تتطلب أيضًا البحث عن المعلومات عند الحاجة، وتوضيح حدود المعرفة، والتمييز بين ما تم التحقق منه وما لا يزال غير مؤكد.
📌 الخلاصة:
النموذج الأكثر موثوقية ليس الذي يجيب عن كل سؤال، ولا الذي يمتنع عن الإجابة كلما واجه صعوبة، بل الذي يوازن بين تقديم المساعدة واحترام حدود المعلومات المتاحة.
وتقع مسؤولية ذلك على أكثر من طرف: من يصمم النموذج ويدرّبه، ومن يضع معايير تقييمه، ومن يستخدم إجاباته دون أن يخلط بين الثقة والدقة.
فالثقة في الإجابة لا تجعلها حقيقة، والاعتراف بعدم اليقين ليس ضعفًا في حد ذاته؛ بل قد يكون الخطوة التي تمنع خطأً كان يمكن تجنبه.
والآن... لو كان بإمكانك الاختيار، فأيهما تفضّل:
• نموذجًا يجيب عن معظم أسئلتك مع احتمال أن يخمّن بثقة... أم نموذجًا يوضح حدود معرفته ويمتنع حين لا يملك أساسًا كافيًا للإجابة؟ ولماذا؟
📚 المصدر العلمي:
Kalai, A. T. et al. Evaluating large language models for accuracy incentivizes hallucinations. Nature، المجلد 653، الصفحات 1047–1051، 2026. نُشرت الدراسة إلكترونيًا في 22 أبريل 2026.
#الذكاء_الاصطناعي#البحث_العلمي#التقنية#غواص_المعاني
أغوص في بحر القراءة... لأعود بدرة.💎
| المنشور الثالث
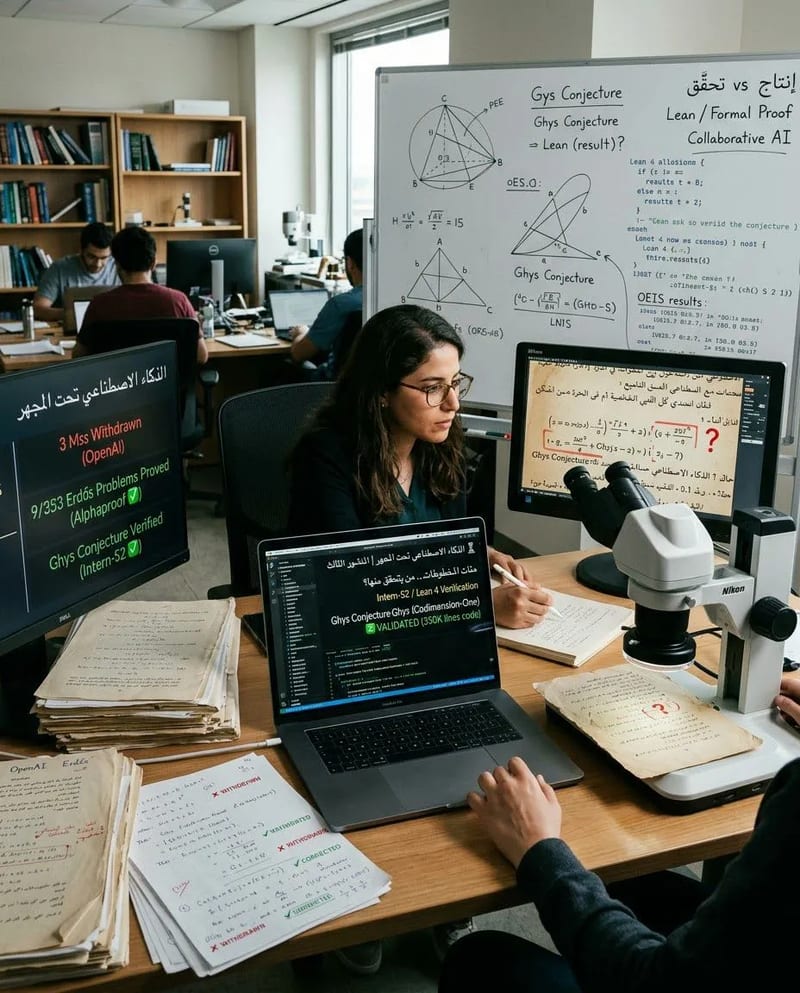
مئات المخطوطات الرياضية... من يتحقق منها؟
في المنشور الأول قلنا إن الإجابة ليست دليلًا، وفي الثاني ناقشنا حدود أدوات كشف النصوص المولدة بالذكاء الاصطناعي.
اليوم ننتقل إلى ميدان يبدو أكثر حسمًا: الرياضيات.
حين يعلن الذكاء الاصطناعي أنه توصّل إلى حلول لمسائل ظلت مفتوحة لعقود،
• فكيف نعرف أن ما أنتجه صحيح؟
• وهل تكفي حجة تبدو مقنعة... أم نحتاج إلى وسيلة مستقلة للتحقق منها؟
لننظر في ثلاثة تطورات حديثة، وما تكشفه عن الفرق بين إنتاج البرهان والتحقق منه.
1️⃣ مئات المخطوطات... ثم تصحيح وسحب
في 6 أكتوبر 2026، نشرت OpenAI مجموعة تضم 722 مخطوطة رياضية مولدة بنموذج داخلي، موزعة على 372 عائلة من النتائج.
وفي اليوم التالي، سُحبت ثلاث مخطوطات بعد اكتشاف خطأ في الإشارة ضمن إحدى الحجج الرياضية، امتد أثره إلى عملين اعتمدا على البناء نفسه. كما أُجريت إصلاحات على 14 مخطوطة أخرى.
أصبح العدد 719 مخطوطة، ويذكر سجل المشروع أن نحو 42% من النتائج الرئيسية لها صياغات رسمية في نظام Lean.
هل يعني ذلك أن بقية النتائج خاطئة؟ لا. فغياب الصياغة الرسمية لا يثبت خطأ النتيجة، كما أن سحب بعض المخطوطات لا يبطل تلقائيًا بقية العمل.
لكن الواقعة تكشف درسًا مهمًا:
كثرة النتائج لا تعني أن كل نتيجة اجتازت الفحص، واكتشاف خطأ قد يستلزم مراجعة الأعمال التي تعتمد عليه.
المصدر الأصلي:
github.com/openai/math/blob/mai…
2️⃣ من الحجة المكتوبة إلى البرهان القابل للتحقق الرسمي
في 15 أكتوبر 2026، أعلن مختبر شنغهاي للذكاء الاصطناعي عن عمل تعاوني بين باحثين ونموذج Intern-S2 أسهم في إثبات حالة من حدسية Ghys في الهندسة الديناميكية.
تثبت الورقة حدسية Ghys في حالة الرتبة المشتركة الواحدة، المعروفة باسم codimension-one، وتشمل الحالة ثلاثية الأبعاد في الفضاء المركب.
ولم يتوقف العمل عند كتابة البرهان؛ فقد صاغ فريق من جامعة بكين المبرهنات الرئيسية في نظام Lean للتحقق الرياضي الرسمي، باستخدام إطار SHEAF.
وبحسب إعلان الفريق، استغرق العمل نحو خمسة أيام، وبلغ حجم الشيفرة قرابة 550 ألف سطر، مع تشغيل ما يصل إلى 100 وكيل بالتوازي.
لكن الدقة تقتضي توضيح أمرين:
أولًا: لا تعني النتيجة حل حدسية Ghys في جميع الحالات؛ فالورقة تثبتها في حالة الرتبة المشتركة الواحدة، بينما تبقى الحالات ذات الرتب المشتركة الأعلى مفتوحة عمومًا.
ثانيًا: يوضح البحث أن المؤلف استخدم نموذج Intern-S2 للمساعدة في تطوير الأفكار والحجج الرياضية، وأنه تحمّل المسؤولية عن التحقق المستقل من الحجج. كما صيغت النتائج المركزية رسميًا في Lean، مع تحقق بشري من المبرهنة النهائية.
إذن نحن أمام تعاون بين الإنسان والذكاء الاصطناعي، تدعمه أدوات للتحقق الرسمي، لا أمام إنجاز مستقل للنموذج وحده.
المصادر الأصلية:
إعلان مختبر شنغهاي:
shlab.org.cn/news/5444307
الورقة البحثية:
arxiv.org/abs/2609.37695
الشيفرة الرسمية:
github.com/frenzymath/Holomorph…
3️⃣ مسائل رياضية مفتوحة... هل تستطيع الآلة حلها؟
في بحث بعنوان «Advancing Mathematics Research with AI-Driven Formal Proof Search»، درس باحثون قدرة أنظمة الذكاء الاصطناعي على البحث عن براهين رسمية لمسائل رياضية مفتوحة.
وبحسب ملخص البحث، حقق النظام الأقوى في الاختبارات النتائج الآتية:
• حل 9 مسائل من أصل 353 مسألة مفتوحة من مسائل إردوش جرى اختبارها.
• أثبت 44 حدسية من أصل 492 حدسية ضمن مجموعة اختبارات مستمدة من موسوعة المتتاليات الصحيحة على الإنترنت OEIS.
هذه مجموعتان منفصلتان من الاختبارات، وليستا مقياسًا عامًا لقدرة النظام على حل جميع المسائل الرياضية المفتوحة.
وتكمن أهمية هذا النهج في استخدام Lean للتحقق من البراهين الرسمية، بدل الاكتفاء بحجج مكتوبة بلغة طبيعية قد تبدو مقنعة رغم احتوائها على أخطاء.
ومع ذلك، يظل من الضروري التأكد من أن الصياغة الرسمية تمثل المسألة الأصلية بدقة، وأن النتيجة لا تتجاوز ما تسمح به افتراضاتها.
المصادر:
البحث العلمي:
arxiv.org/abs/2605.22763
مستودع النتائج:
github.com/google-deepmind/alph…
🔬 ما الفرق بين إنتاج البرهان والتحقق منه؟
لفهم هذه التطورات، ينبغي التمييز بين ثلاثة مستويات:
إنتاج البرهان: أن يقترح النظام حجة أو مسارًا لحل مسألة رياضية.
التحقق الرسمي: أن تُصاغ الحجة بلغة رياضية دقيقة يستطيع نظام مثل Lean فحص خطواتها وفق قواعده وافتراضاته.
المراجعة العلمية: أن يفحص المختصون معنى النتيجة، وصحة صياغة المسألة، والافتراضات المستخدمة، ومدى جدة النتيجة وأهميتها.
هذه المستويات يكمل بعضها بعضًا، لكنها ليست شيئًا واحدًا.
فالتحقق الرسمي يقدم ضمانًا قويًا بشأن صحة البرهان المرمّز ضمن النظام وافتراضاته، لكنه لا يثبت وحده أن الصياغة المرمّزة تطابق المسألة المقصودة تمامًا، ولا يحسم أهمية النتيجة العلمية.
وفي المقابل، ليس كل برهان رياضي غير مكتوب بلغة رسمية برهانًا خاطئًا؛ فالبراهين التقليدية يمكن أن تكون صحيحة ومقبولة بعد الفحص والمراجعة العلمية.
الخلاصة
يفتح الذكاء الاصطناعي آفاقًا مهمة أمام البحث الرياضي، من اقتراح أفكار جديدة إلى استكشاف مسارات قد يصعب على الباحثين اختبارها يدويًا.
لكن لا ينبغي أن نخلط بين كثرة النتائج وصحتها، ولا بين الحجة المقنعة والبرهان الذي اجتاز الفحص.
قيمة الإنجاز ليست في أن تنتج الآلة برهانًا فحسب، بل في أن يصبح قابلًا للفحص والنقد وإعادة التحقق.
وهذا هو جوهر منهجنا في «الذكاء الاصطناعي تحت المجهر»:
🔬 نتحقق أولًا، ونحلل ثانيًا، ثم نكتب للنشر.
#غواص_المعاني
أغوص في بحر القراءة... لأعود بدرة.💎
#الذكاء_الاصطناعي_تحت_المجهر#الذكاء_الاصطناعي#الذكاء_الاصطناعي_إلى_أين؟#الرياضيات#البحث_العلمي